M5 Ultra誕生の背景


※本サイトは、アフィリエイト広告および広告による収益を得て運営しています。購入により売上の一部が本サイトに還元されることがあります。
Apple M5 Ultra
2026年8月に発表された「Mac Studio (M5 MaxまたはM5 Ultra)」では、M5 Ultraを搭載したモデルが登場した。
M5 UltraはM5 Maxを2個Ultra Fusionで結合した最強のAppleシリコンだ。今回はこのM5 Ultraについて深掘りしてみたい。
M4 Ultraがスキップされた理由
まずM4 UltraのベースとなるM4 Max自体が、モノリシックダイ(単一のシリコンダイ)としてはレチクル限界(回路をダイに焼き付けるEUVリソグラフィ技術の限界サイズ)に達していた。
M4 Maxの総トランジスタ数は公式には発表されていないが、M3 Maxが920億トランジスタ、M4がM3比で12%トランジスタ数が増えていたことから考えると、M4 Maxでは1,000億トランジスタを越えていたことは容易に想像できる。
M4 Ultraを作るには、M4 MaxにさらにUltra Fusionのためのインターコネクトエリアを設ける必要があり、これはさらに数%ダイサイズが大きくなることを意味している。
ちなみにモノリシックダイとしては最大級とされるNVIDIA Blackwellは1つのダイで1,040億トランジスタなので、M4 Maxはこれと同等、もしくはそれを上回る巨大なダイだったことは間違いない。
レチクル限界に近いダイサイズは単一ウエハーからの獲得数が少なくなるだけでなく、歩留まりも悪化するため極めて高価格になる。
もう1つの理由はすでにM5のリリースを目前に控えていたことだ。
M3 Ultraのリリースが2025年3月、M5が同年10月のリリースなので、M4 Ultraはその企画時点で、すでに設計の終わっているM5シリーズとの性能比較ができたはずだ。M5 Ultraのような膨大なGPUとメモリ規模を持つAppleシリコンの用途は、AppleがMac Studioの発表時に訴求したように、大きなAIモデルを高速に実行できることである。
この点において、Neural Acceleratorを有するM5シリーズと、それを持たないM4シリーズの性能差は圧倒的だ。
Apple自身がM5シリーズのAI性能をM4シリーズの4倍、と紹介しているように、AI用途においてM4 UltraはM5 Maxにすら劣る可能性が高い。それを踏まえたうえで、あえてM4 Ultraのリリースを急ぐ必然性はなかったと考えられる。
M5 Ultraの登場とその構造
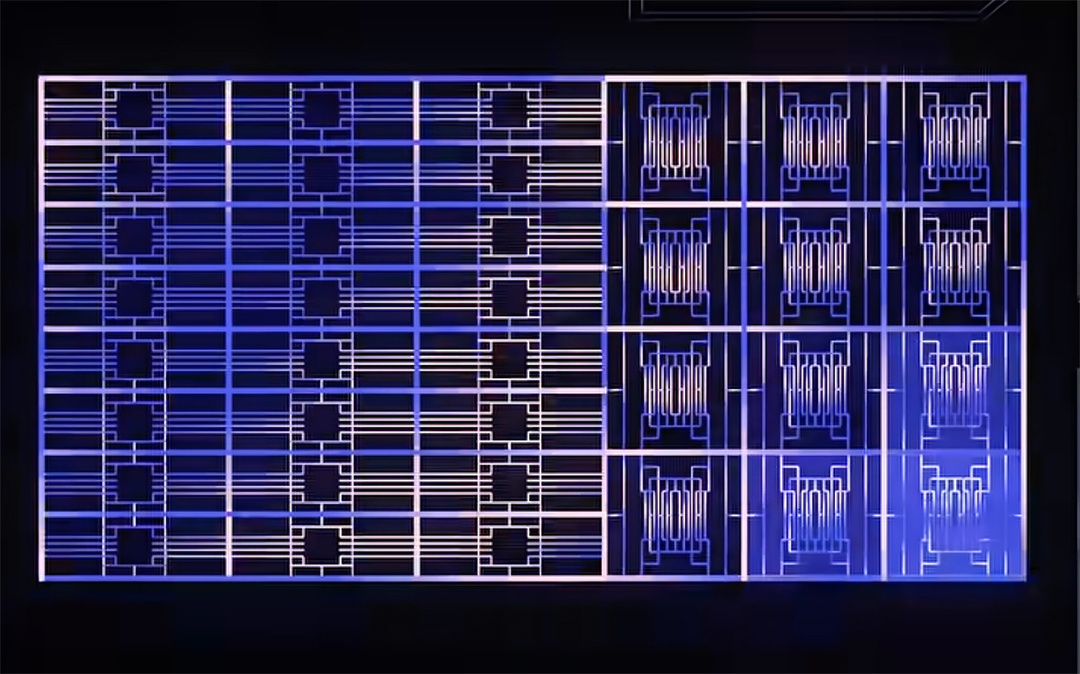
M5 Ultra
M5 ProとM5 Maxでは、ついにWMCM(Wafer-level Multi Chip Module)が採用された。これは複数のダイを高密度に結合して1つのチップを作り上げるパッケージ技術で、M5 Pro/Maxに採用されたのはTSMCのSoIC-mH(Small Outline Integrated Circuit Molding-Horizontal)だと考えられる。
M5 Pro/MaxのダイはCPUダイとGPUダイに分割され、これをチップレット上に横に並べてモールディング(Molding-Horizontal)し、両者をインターポーザでパンプレス接続する。これによってUltra Fusionより高密度かつ高速な伝送路を実現し、UMA(Unified Memory Architecture)のメリットを損なうことなくWMCMを実現している。
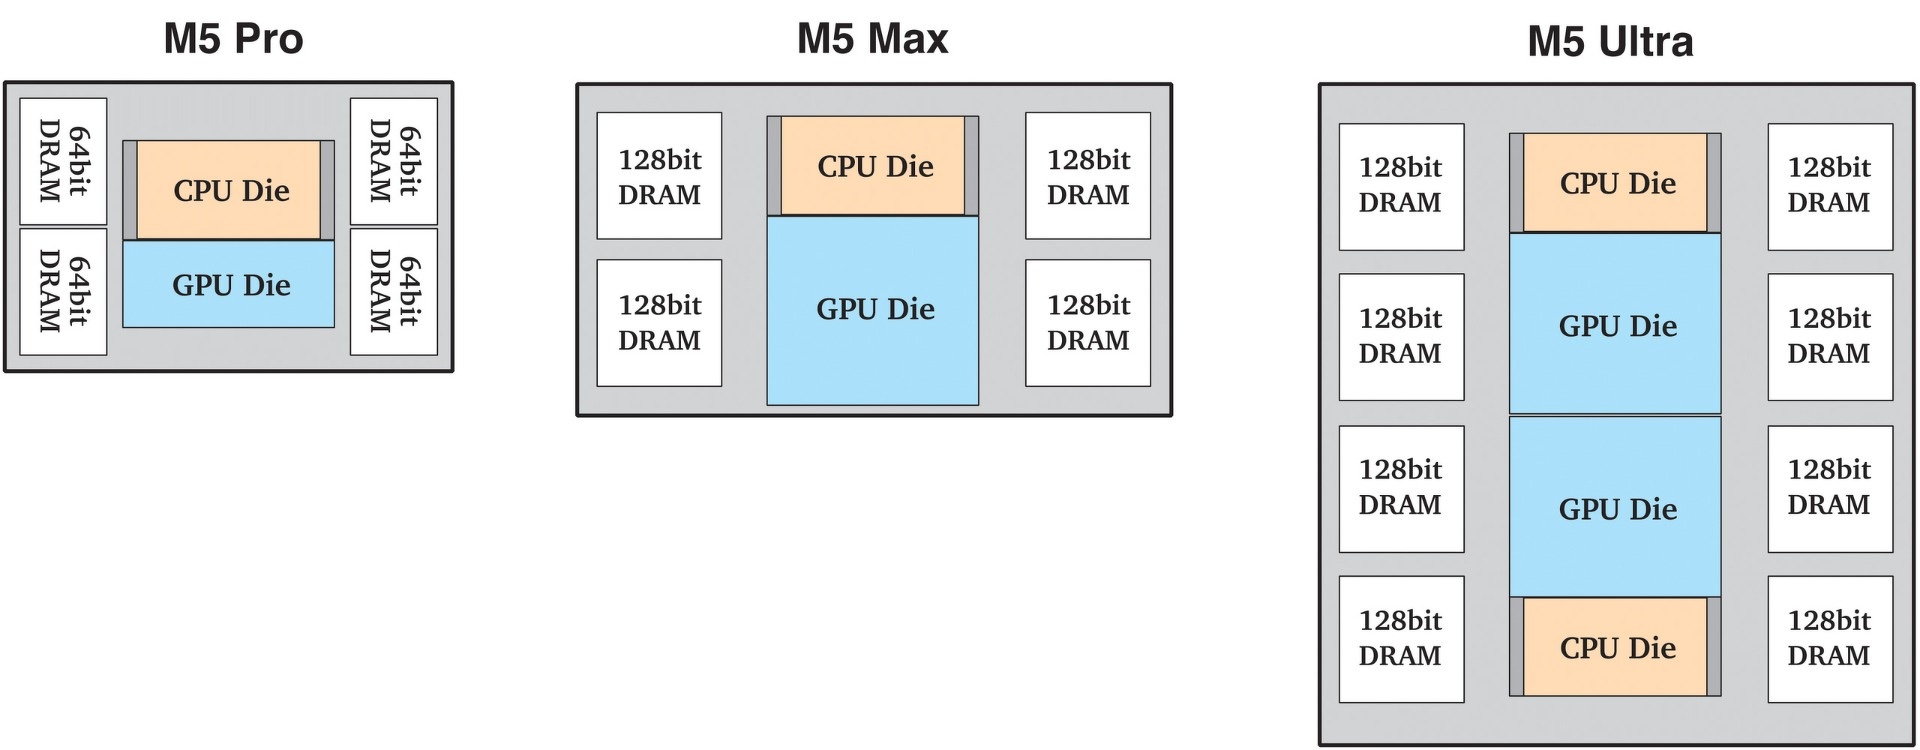
M5シリーズ
M5 Pro、M5 Max、M5 Ultraのチップデザイン予想。従来モノリシック(単一)ダイだったM5 ProとM5 MaxはCPUダイとGPUダイに分割された。これによって両者のCPUダイは共通化され、GPUダイはM5 ProとM5 Maxで別設計となり、GPUコア数とメモリ帯域が1:2となっている。M5 UltraはM5 Maxをチップ(サブスレート)上に2つ搭載し、両者をUltra Fusionで接続した構成となった。
M5 Ultraはその結合したM5 Maxを2つ、さらにUltra Fusionで結合したものだ。
その接続帯域はM2 Ultraの2.5TB/秒以上から、M5 Ultraでは4.4TB/秒以上へと高速化されている。このようにM5 Ultraでは目的や性能の異なる2種類のWMCM技術が併用されていると考えられる。
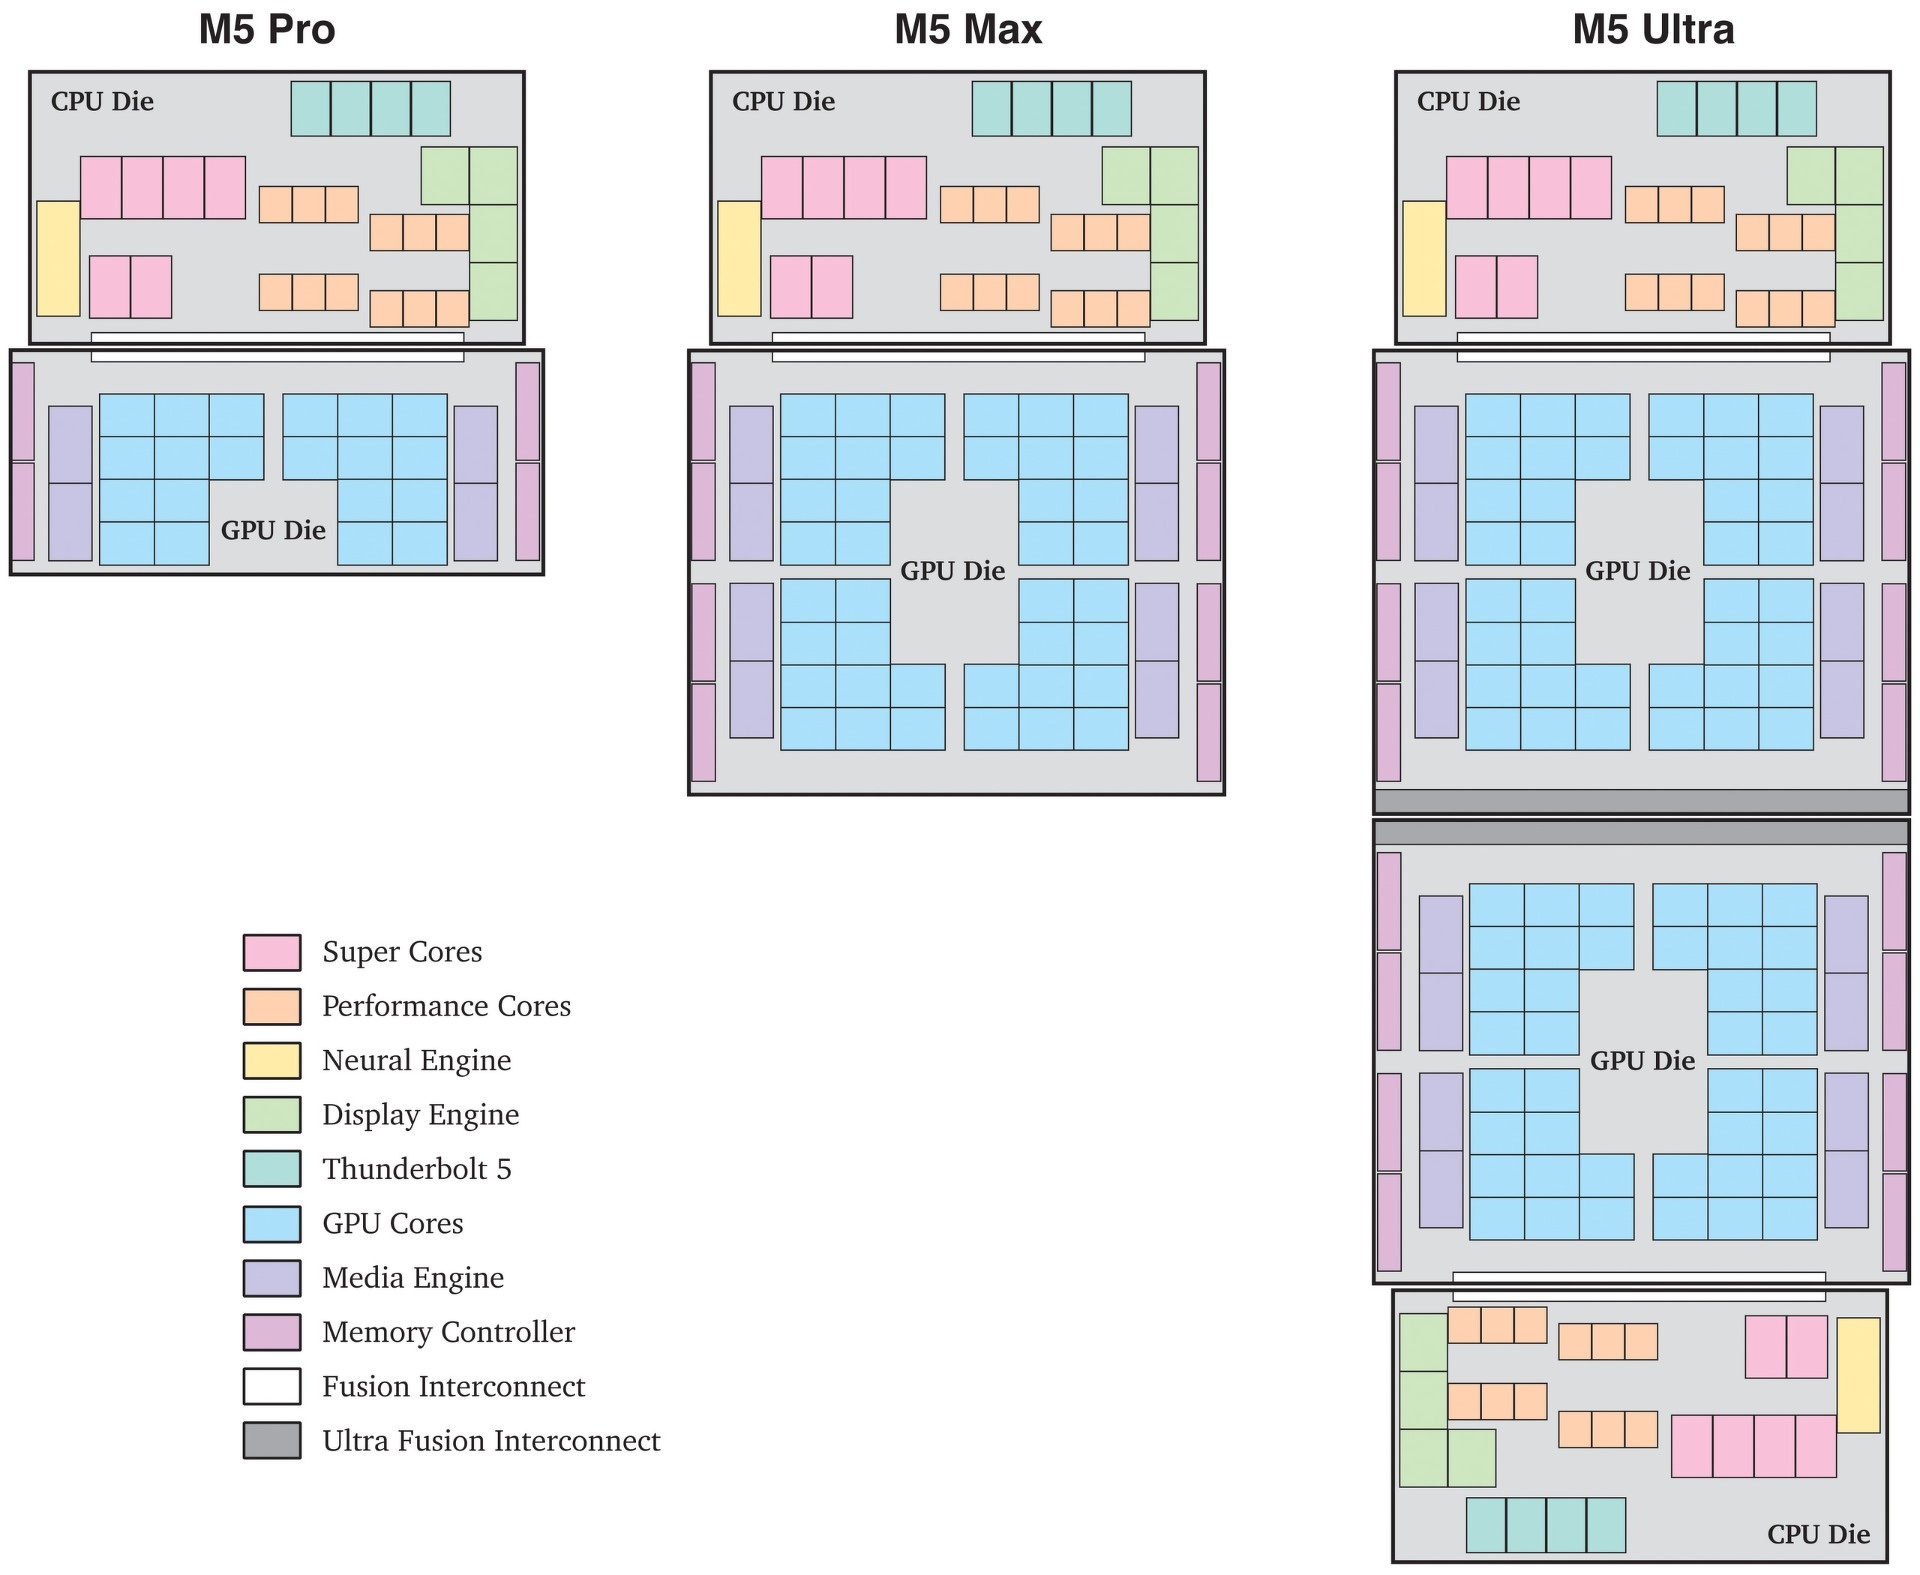
M5シリーズ詳細
CounterPointの解析結果を参考に推測したM5シリーズの内部レイアウト。M5 ProとM5 MaxのCPUダイは共通で、M5 MaxのGPUダイはM5 ProのGPUダイを上下反転して2個結合した設計になっている。GPUダイの設計手法はモノリシックダイのM1 Pro/MaxやM2 Pro/Maxと共通しており、そこにWMCM技術を導入したのがM5 Pro/Maxであることがわかる。
参考資料:Apple M5 Pro Chip Teardown Analysis: Apple Silicon Chiplet Era Beckons(Counterpoint Research)
待ち望まれたMac StudioへのM5 Ultra搭載
M5 MaxやM5 Ultraのような膨大なGPUコアとメモリ規模を持つAppleシリコンと、それを搭載するMac Studioの魅力は、Appleがそのリリースで提示したようにさまざまなローカルAI処理を単体でこなせる点だ。そしてこのような利用シーンで重要になるのが、AI(GPU)が利用できるメモリサイズだ。
市場ではNVIDIAのGPUを搭載した製品がこのカテゴリーを席巻している。それはCUDAという圧倒的なエコシステムの恩恵と、NVIDIA GPUの優れたAI演算性能に支えられている。
その一方で個人ユーザが導入できるソリューションでは、圧倒的にメモリが足りない。最強のGPUカードとされるGeForce RTX 5090ですら32GBが上限だ。RTX PRO 6000 Blackwellなら96GBを選べるが、乗用車が購入できる価格帯になる。(それもGPUカードだけで)
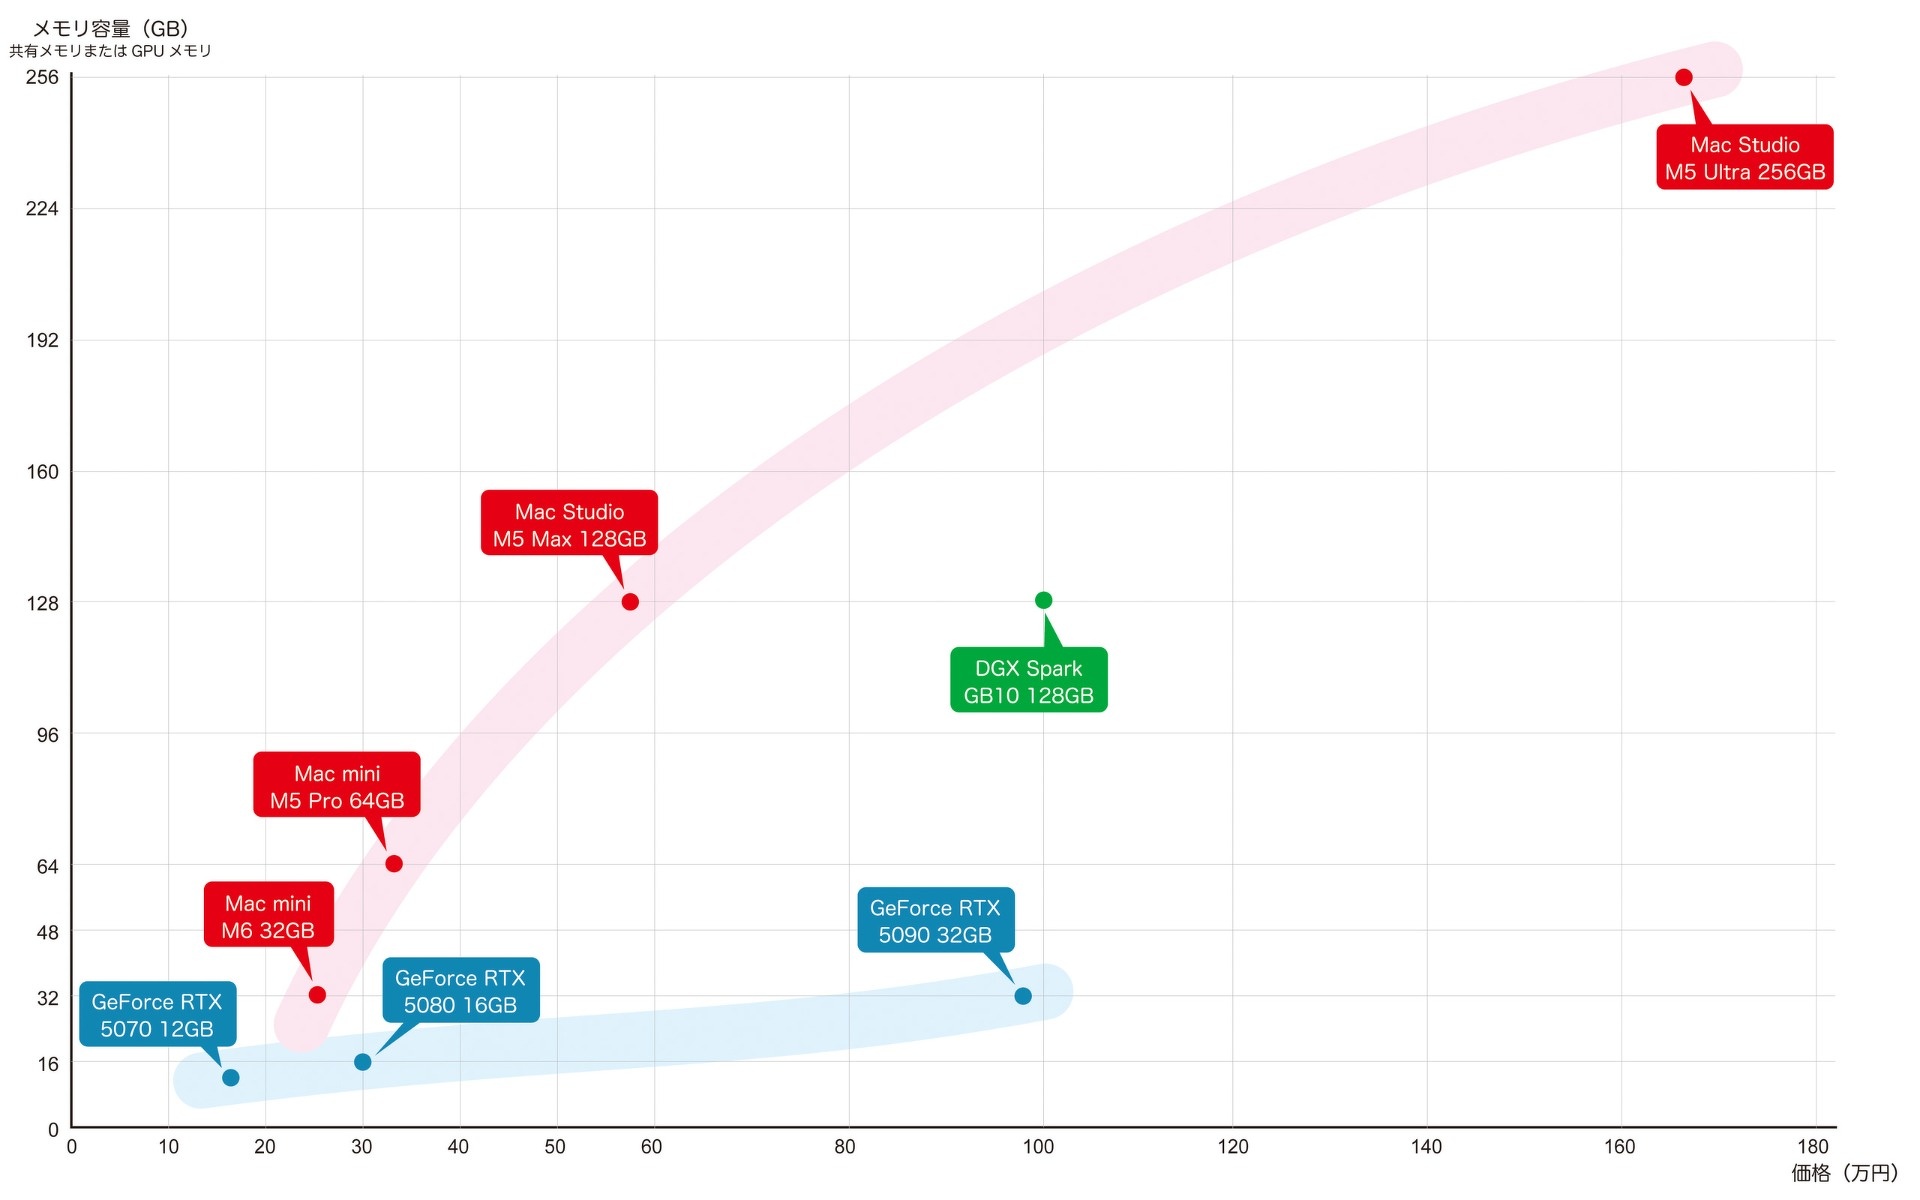
メモリ容量と価格
発表されたMac miniおよびMac Studioのメモリ仕様と価格を、NVIDIAの最新のGeForce RTX 50シリーズGPUカード(PC本体は別途必要)と比較した。NVIDIAのBlackwell GPUは圧倒的なAI演算性能を誇るが、反面搭載メモリ容量に大きな制限がある。ローカルAIでは「搭載されたメモリ以上のサイズのAIモデルを動かせない」という制約があるため、より賢い(パラメータ数の大きい)モデルを動かすには多くのメモリが必要になる。またAIエージェントをローカル環境で動かすには、さらに多くのメモリが要求される。
一方、UMAを採用するAppleシリコンでは、メインメモリの多くをGPUに割り当てることができる。しかもメモリオプション追加のコストは(最近は高騰しているものの)かなり低い。このため2~3年ほど前からMac miniやMac StudioがAIサーバとして選ばれる機会が増えた。(一時はM4/M4 Pro搭載Mac miniが市場から消えるほどに)今回Neural Acceleratorを搭載したM5シリーズのラインナップが出揃ったことで、このようなAIニーズにおける魅力が一層増したことは疑いの余地がない。
さらに最近はLLMだけではなく、AIエージェント(自立型AI)の利用が急速に普及している。自立型AIは自ら「判断と行動」を行うため、プライバシーや機密保護、そして大規模なトークン消費にともなうクラウドコストの爆発的増加などの観点から、ローカル(またはオンプロミス)生成のニーズが増大している。
AIエージェントでは今まで以上に多くのメモリと、高いCPU性能も求められるようになる。そのすべてをバランス良く、かつ比較的リーズナブルで実現する新しいMac mini(M6またはM5 Pro)とMac Studio(M5 MaxまたはM5 Ultra)は、AI用途でPCを使うユーザからみて非常に魅力的な存在となることは違いないだろう。
執筆:MysticRoom Tak.