Apple、パフォーマンスとAI演算に大幅な向上をもたらす「M6」チップと「M5 Ultra」チップを発表


※本サイトは、アフィリエイト広告および広告による収益を得て運営しています。購入により売上の一部が本サイトに還元されることがあります。

M6:M5 Ultra
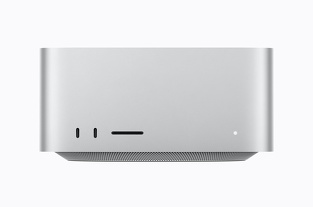
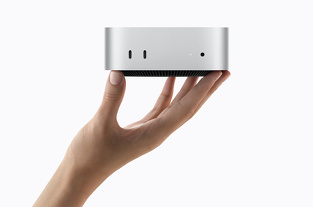
Appleが、パフォーマンスとAI機能を飛躍的に向上させる、新しい「Mac mini(M6)」に搭載されるM6チップと、新しい「Mac Studio(M5 Ultra)」に搭載されるM5 Ultraチップを発表しています。
Apple初の最高水準の2ナノメートルチップであるM6では、すべての演算ブロックを進化させ、パフォーマンスのあらゆる面で向上をもたらしています。
このチップは、世界最速のCPUコアを備えたより大きな12コアCPUコンプレックスと、Neural Acceleratorを備えたより大きな12コアGPU、デュアル16コアNeural Engine、そして最大170GB/sのユニファイドメモリ帯域幅を備えています。
プロとAIワークロードのための究極にパワフルなチップであるM5 Ultraは、次世代のUltraFusionテクノロジーを使用し、Mシリーズのシステムオンチップ(SoC)で初めてクアッドダイアーキテクチャを形成しています。
このチップは最大36コアのCPUと最大80コアのGPUを搭載し、M3 Ultraと比較して50パーセント高速な1.2TB/sという膨大なユニファイドメモリ帯域幅を備えています。

M6チップ
M6チップは、最先端の2ナノメートルプロセステクノロジーを使って作られ、より小さなダイにより高い密度でトランジスタを搭載することで、パフォーマンスと電力効率が大幅に向上しています。
2つのスーパーコア、4つの高性能コア、6つの高効率コアで構成され、メモリ帯域幅153.6GB/s仕様(LPDDR5X-9600 x2)と、メモリ帯域幅171.2GB/s仕様(LPDDR5X-10700 x2)の2種類があります。
M6チップはまた、デュアル16コアNeural Engineを導入し、前世代と比較して最大2倍高いピーク演算性能を発揮し、オンデバイスAIのワークフローをさらに高速に実行します。
さらに、M6チップは、シェーダコアアーキテクチャのアップデート、Dynamic Caching、ハードウェアアクセラレーテッドレイトレーシングなど、Appleの最新の先進的なグラフィックス機能も提供します。
M6チップは、ネイティブFP8ハードウェア処理によってAIワークロードのパフォーマンスとメモリ効率も向上します。

M5 Ultraチップ
M5 Ultraチップは、UltraFusionを利用して2つのデュアルダイM5 Maxチップを接続し、Appleシリコンで初めてクアッドダイアーキテクチャを形成しています。
UltraFusionは、ダイ間の帯域幅を4.4TB/s以上に増やし、接続密度を6倍以上に高め、この超低レイテンシーと高速な帯域幅を組み合わせた相互接続によって、4つのダイは1つの統一されたプロセッサとして動作します。
M5 Ultraチップはまた、12のスーパーコアと24の高性能コアで構成される最大36コアの大きなCPUを搭載し、M3 Ultraと比較して最大1.25倍高いシングルスレッドのパフォーマンスと、最大1.3倍高いマルチスレッドのパフォーマンスを発揮します。
M5 Ultraチップは、最大80コアの次世代GPUを搭載し、各コアにNeural Acceleratorを組み込むことで、AI利用でのピーク時のGPU演算性能がM3 Ultraチップと比較して最大4.5倍、M1 Ultraチップと比較して6倍以上向上しています。
GPUは、第2世代のDynamic Cachingを備えたApple最新のシェーダコアのほか、ハードウェアアクセラレーテッドメッシュシェーディングと第3世代のレイトレーシングを搭載し、M3 Ultraチップよりも最大40パーセント高速なグラフィックスパフォーマンスを提供します。

Appleシリコン表
詳しい構成はAppleシリコン表を参照して下さい